개요
이전 포스팅을 보면 MySQL Skip Locked를 활용해서, 여러 개의 프로세스가 자원에 접근할 때 Deadlock이나 동시성 이슈가 발생하지 않도록 했다. 전체 실행 시간이 단축된 것은 덤이며, 별도의 인프라를 더 추가할 것도 없이 간단한 방법으로 쉽게 문제를 해결하고 개선할 수 있었다.
하지만 내용을 보다보면, 프로세스가 해당 자원(Row)을 처리했음을 표시하는 processedDate라는 날짜 필드를 추가했는데 여기서 계속 의문이 들었다. 이전 포스팅의 6-1. 개인적인 생각이라는 내용을 읽어보면, 상태 값이 있을 때 Skip Locked가 강력하게 활용되는 것 같다고 적어놓았다.
1. 그래서 Skip Locked가 왜 더 별로인데?
일단, 나의 프로젝트는 UPDATE 쿼리를 사용해서 기존 데이터를 계속 갱신한다.
프로젝트가 다루는 데이터에는, 사실 PENDING, PROCESSING, SUCCESS 등 명시적인 상태를 가진 컬럼이 없다.
그래서 processedDate라는 컬럼을 넣어 프로세스가 처리한 시간을 저장하고 있는데, 이것의 단점이 매우 크다.
일단 processedDate는 Nullable하고, 각 스케줄러는 Null 값을 가진 데이터를 가져와서 갱신한다. 이것으로 인해 발생하는 단점은 다음과 같다.
- 만약 같은 방식으로 처리한다면, processedDate 필드를 Null로 다시 변경해야한다.
- ‘이 데이터가 이번에 갱신되어야 할 데이터인가?‘라는 논리를 정해야한다. 스케줄러 주기에 맞춰 갱신 타겟을 인식하는 공식을 만들어야 한다.
ex)NOW() - processedDate >= BATCH_PERIOD - 어떤 데이터가 처리되는지 모니터링이 까다로워진다. processedDate 필드를 확인하기엔 직관적이지 않고, 트랜잭션을 확인하기에는 information_schema 관련 쿼리를 날려야 한다.
- 고도화된다고 했을 경우, processdDate 외에도 스케줄러용 컬럼이 덕지덕지 붙는다.
즉, 시간에 의존하고 있다. 갱신 날짜가 오래되었거나 Null인 데이터를 찾아야하는데, 이 포인트를 고민하는 것부터 자체가 추후 유지보수에 큰 영향을 끼칠 것이라 판단했다.
그래서 나의 프로젝트를 봤을 때, 주기적으로 기존 데이터를 갱신해야하는 성격 때문에 다른 기술이 필요하다 판단했고, Status를 관리하는 컬럼이 없다면 Skip Locked를 사용하는 것은 부적합한 기술 적용이라고 생각이 들었다.
2. 그럼 왜 Producer/Consumer인데?
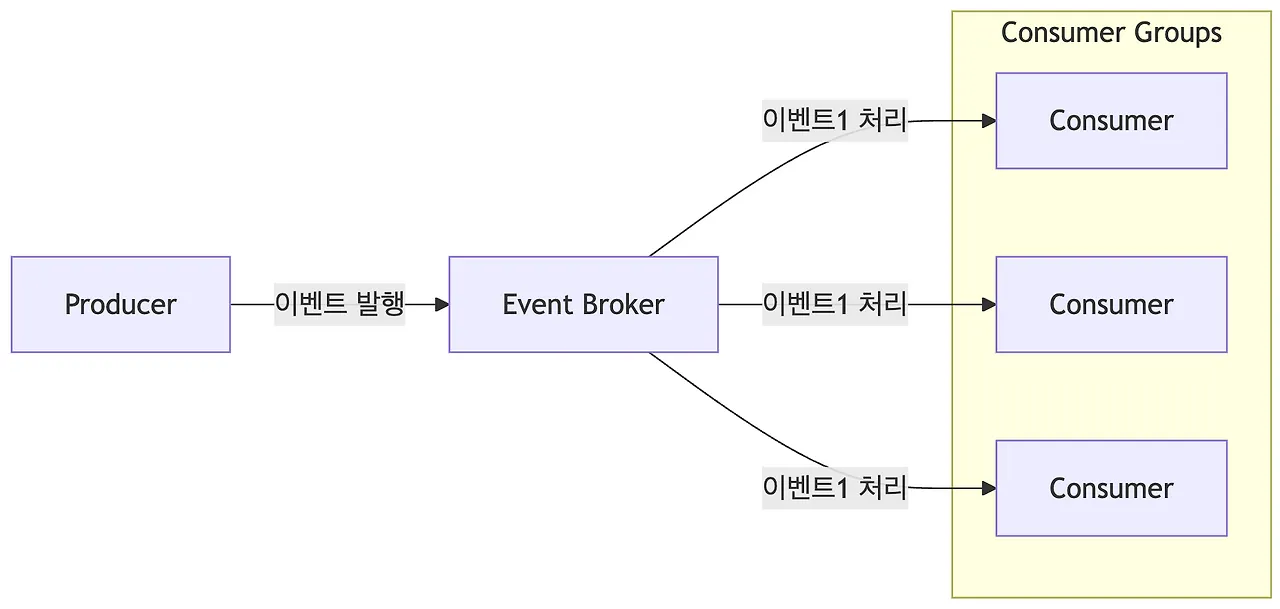
Producer에서 처리할 이벤트를 생성하고 Event Broker에 발행한다. Consumer Groups 내부의 Consumer들은 브로커에 적재된 이벤트를 하나씩 가져와 처리하는 것이 이 패턴의 일반적인 구조이다 Pub/Sub와 크게 다른 점은 브로커가 각 Consumer에게 Broadcast하는 것이 아니라, Consumer가 ‘하나씩’ 가져가는 것이 포인트이다.
위의 1에서 작성했던 대로, Producer/Consumer 패턴이 왜 이 프로젝트와 맞는지 다음과 같이 고민했다.
- 갱신 방식
Producer가 일정 주기마다 갱신할 데이터를 이벤트 브로커에 넣는다. Consumer는 이벤트를 가져가서 처리하기만 하면 된다. 동시성 이슈가 없을 뿐더러, processedDate같이 복잡하게 관리할 포인트가 줄어든다. - 병목 방지
이 프로젝트는 외부 API를 사용하고 있는데, 응답 시간이 길어질 수록 Skip Locked를 유지하게 되면 커넥션과 락을 그만큼 오래 붙잡을 것이다. 만약 API 응답이 3초 걸리고 프로세스가 50개라면, DB 커넥션 50개가 3초 동안 아무것도 안하기 때문에 Connection Pool 고갈 가능성이 있다. - 추적
이벤트 브로커에서 작업 상태를 쉽게 추적할 수 있다. 어떤 Consumer가 이 이벤트를 처리하는지 확인할 수 있고, 무엇이 실패했는지 그리고 재처리를 할 수 있다는 것이 강점이다. - 확장
만약 처리해야 할 데이터가 많아진다면 Consumer의 수를 늘린다.
2-1. 많고 많은 것 중에서 Redis Streams를 선택한 이유는?
가장 먼저 떠오른 기술은 Kafka였다.
하지만 프로젝트에서 관리하는 데이터는 고작 120건이었고, 적은 데이터를 처리하기 위해 Kafka를 구축하고 관리하는 것은 오버 엔지니어링이다.
경량 데이터들을 처리하기엔 Kafka나 RabbitMQ는 이 프로젝트에 적용하기엔 무겁고 러닝커브가 매우 클 것이라 판단했다.
그 외에도 이유는 다음처럼 나열할 수 있다.
(필자의 Producer/Consumer 아키텍처 학습에도 이유가 있긴 하다.)
- Redis는 인메모리 기반이라, 디스크 기반인 Kafka, RabbitMQ보다 I/O Latency가 낮다. 빠르게 처리할 수 있다.
- 메모리 기반이지만 유실되어도 상관없다. 원본 데이터는 RDB에 있고 스케줄러는 주기적으로 돌기 때문에, Producer로 다시 이벤트를 발행해주도록 한다. (필요에 따라 Disk에 스냅샷 형태로 저장할 수 있다.)
- Kafka의 장점인 Consumer Group 기능으로 여러 Consumer가 데이터를 안전하게 나눠 처리한다. ACK 메커니즘을 통해 재처리를 할 수 있다.
그렇다면, Streams 말고도 Pub/Sub, List 등이 있다. 그래도 왜 Streams일까?
- List에서 데이터를 꺼내가는 순간 Redis에서 삭제된다. 비정상적으로 종료된다면 재처리를 구현하기 까다롭다. → 위에서 Producer로 이벤트를 다시 발행하면 된다고 했지만 ACK가 뒷받침했기 때문에 가능한거지, 계속 비정상적으로 처리된다는 가정하에 List의 재처리는 까다로워진다.
- Pub/Sub는 처리할 Worker가 없으면 이벤트가 유실된다. 또한, Subscriber들에게 일괄적으로 발행하기 때문에 채팅이나 푸시 알람으론 적합하지만, 중복 없이 처리할 수 있는 것은 아니다.
종합적으로 봤을 때 다음과 같다.
| Kafka | RabbitMQ | Redis Streams | Redis Pub/Sub | Redis List | |
|---|---|---|---|---|---|
| 재처리가 가능한가? | O | O | O | X | X |
| 유실 가능성이 있는가? | X | X | O | O | O |
| 저장 위치 | Disk (강력하다) | Memory + Disk | Memory | Memory | Memory |
| 전달 방식 | Pull (이벤트를 가져감) | Push (이벤트를 컨슈머에 전송) | Pull | Pull | Push |
| 처리 순서 | 등록된 순서대로 처리. 또는 처리 우선순위를 지정 가능 | ||||
| 관리 비용 | 높음 | 높음 | 낮음 | 낮음 | 낮음 |
3. 어떻게 구현할 것인가?
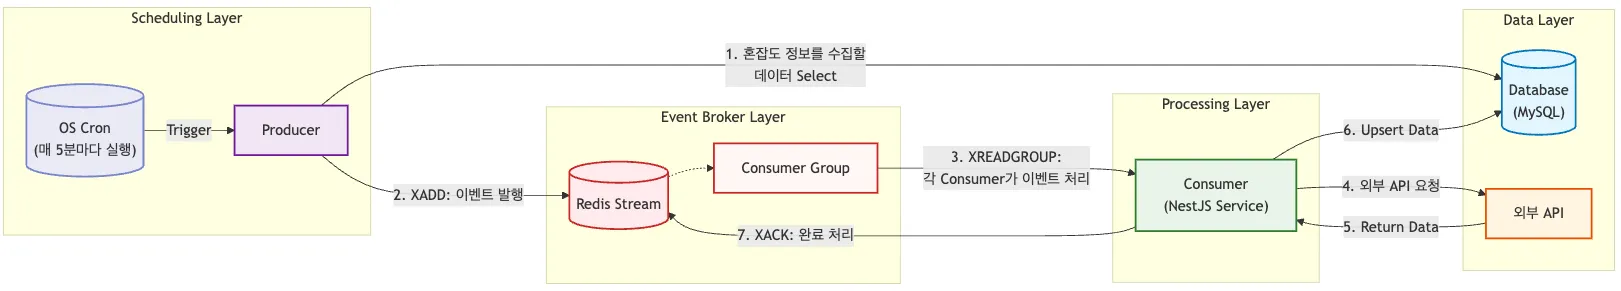
기본적으로 갱신해야할 데이터 셋은 RDB에 저장되어 있기 때문에, Producer는 RDB에서 데이터를 가져와 이벤트를 발행하고 이벤트 브로커에 전달한다. Stream 데이터를 바라보는 Consumer Group에서 Consumer가 이벤트를 가져갈 수 있도록 하고, 외부 API를 통해 갱신할 정보를 수집하고 가공한다. 가공된 데이터는 RDB에 갱신하고, Redis에 ACK를 전송하여 이벤트가 정상적으로 처리됐음을 알린다.
플로우는 다음과 같다.
4. 구현
Redis Stream에 이벤트를 발행할 Producer, 이벤트를 가져와 처리할 Consumer를 각각 구현한다.
4-1. Producer 구현
const REDIS_STREAM_KEY = 'place:population:queue';

const TypeOrmRootModule = TypeOrmModule.forRootAsync({ useClass: MysqlConfigService });
const RedisRootModule = RedisModule.register({ host: config.redisHost, port: config.redisPort });

@Module({
  imports: [TypeOrmRootModule, RedisRootModule],
})
class PlacePopulationModule {}

async function placePopulationProduce() {
  const app = await NestFactory.createApplicationContext(PlacePopulationModule, {
    logger: ['error', 'warn', 'log'],
  });
  const logger = new Logger('PlaceProducer');

  try {
    const dataSource = app.get(DataSource);
    const redisService = app.get(RedisService);

    const places = await dataSource.getRepository(Place).find({
      select: ['idx', 'name'],
      where: {
        status: PlaceStatus.Activated,
      },
    });

    if (places.length === 0) {
      logger.warn('No places found.');
      return;
    }

    const pipeline = redisService.client.pipeline();

    for (const place of places) {
      pipeline.xadd(REDIS_STREAM_KEY, '*', 'placeIdx', place.idx, 'name', place.name);
    }

    await pipeline.exec();

    logger.log(`✅ Place Producer Done. Total ${places.length}. `);
  } catch (e) {
    logger.error('❌ Place Producer Error', e);
    process.exit(1);
  } finally {
    await app.close();
  }
}

placePopulationProduce();
Cron으로 주기적으로 실행되는 스크립트이며, RDB에서 혼잡도 데이터를 수집할 장소 정보를 가져온다. 웹 서버를 띄우지 않고 필요한 로직만 수행하도록 NestJS Standalone Application으로 제작했다. 핵심 로직은 다음과 같이 나열한다.
- XADD + Redis Pipline 사용
- XADD 연산을 실행할 때 Redis Pipeline으로 명령어를 한번에 실행한다.
- 한 번의 네트워크 요청으로 처리하여 Stream에 적재한다.
- Ad-hoc 모듈 정의로 Bootstrap 최적화
- AppModule을 통째로 불러오지 않고, 스크립트 실행해 필요한 TypeORM과 Redis만 묶은 Ad-hoc 형태이다.
- Bootstrap 시간을 최적화한다.
- Entry ID 생성
- Stream에 저장되는 이벤트는 각각 아이디를 가진다.
- XADD에서 ’*‘을 사용하여 각 엔트리마다
<millisecondsTime>-<sequenceNumber>형태로 아이디를 생성한다.
4-2. Consumer 구현
@Injectable()
export class PlacePopulationConsumer implements OnModuleInit, OnModuleDestroy {
  private readonly logger = new Logger(PlacePopulationConsumer.name);
  private readonly CONSUMER_NAME: string = `consumer-${Math.random().toString(36).substring(7)}`;
  private isRunning = true;

  constructor(
    private readonly redis: RedisService,
    private readonly placePopulationService: PlacePopulationService,
    private readonly jobLogService: JobLogService,
  ) {}

  async onModuleInit() {
    try {
      await this.redis.client.xgroup(
      	'CREATE',
        PLACE_POPULATION_REDIS_KEY,
        PLACE_POPULATION_REDIS_GROUP,
        '0',
        'MKSTREAM'
      );
      this.logger.log('Consumer Group Created');
    } catch (e) {
      if (!e.message.includes('BUSYGROUP')) {
        this.logger.error('Redis Group Error', e);
      }
    }

    await this.run();
  }

  async run() {
    this.logger.log(`[${this.CONSUMER_NAME}] Started Listening...`);

    while (this.isRunning) {
      const start = new Date();

      try {
        const streamData = (await this.redis.client.xreadgroup(
          'GROUP', PLACE_POPULATION_REDIS_GROUP, this.CONSUMER_NAME,
          'COUNT', 1,
          'BLOCK', 5000,
          'STREAMS', PLACE_POPULATION_REDIS_KEY,
          '>',
        )) as unknown as any[];

        if (!streamData) {
          continue;
        }

        // streamData = [[streamKey, [[messageId, [key, val, key, val, ...]]]]]
        const [_, messages] = streamData[0];
        const [messageId, fields] = messages[0];
        const parsedData = this.parseFields(fields);

        await this.processData(parsedData);

        await this.redis.client.xack(PLACE_POPULATION_REDIS_KEY, PLACE_POPULATION_REDIS_GROUP, messageId);
        await this.redis.client.xdel(PLACE_POPULATION_REDIS_KEY, messageId);

        this.logger.log(`[${parsedData.name}(${parsedData.placeIdx})] successfully updated`);
      } catch (e) {
        this.logger.error(`Stream Error: ${e.message}`);
        this.jobLogService.add(this.CONSUMER_NAME, `Stream Error: ${e.message}`, (new Date().getTime() - start.getTime()) / 1000);
      }
    }
  }

  onModuleDestroy() {
    this.isRunning = false;
    this.redis.client.disconnect();
  }
}
Producer가 발행한 이벤트를 가져와서 처리할 수 있도록 Consumer를 구현한다. NestJS 생명주기를 활용하여 앱이 실행됨과 동시에 Consumer Group을 설정하고 run 함수를 실행하도록 한다. 원활한 처리와 로깅을 위해 CONSUMER_NAME은 랜덤한 이름을 가지도록 했다. 핵심 로직은 다음과 같이 나열한다.
- Consumer Group 생성 (onModuleInit)
- 앱이 시작되면 가장 먼저
XGROUP CREATE연산으로 Consumer Group을 생성한다. 이미 그룹이 존재하는 경우를 대비해BUSYGROUP에러에 대해 방어하는 로직을 추가한다. - 덕분에 여러 인스턴스를 띄워도 그룹 내에서 이벤트를 중복없이 나눠 가질 수 있다.
- 연산 형태는 XGROUP CREATE
<id | $> MKSTREAM <id | $>: Consumer Group이 어디서부터 이벤트를 읽을지 결정한다. 0이면 스트림의 처음부터 읽고, $면 그룹 생성 이후에 발생하는 이벤트만을 처리한다. 그 외에도 Entry ID로도 설정 가능하다.MKSTREAM: 지정한스트림이 존재하지 않을 경우, 자동으로 빈 스트림을 생성
- 앱이 시작되면 가장 먼저
- XREADGROUP으로 이벤트 수신
- 1개의 이벤트를 수신하여 처리하도록 한다.
- 이벤트가 없는 상황을 생각하여, Blocking Read(BLOCK 5000) 처리를 한다. 5초간 대기하며 불필요한 CPU 소모를 막는다. (Long Polling)
- ’>‘는 아직 그룹 내 다른 워커가 읽지 않은 새로운 이벤트만 요청한다.
- 이벤트 처리 완료 (XACK + XDEL)
- 비즈니스 로직 수행이 문제없이 완료되면 Redis에게 작업을 완료했다는 ACK 메시지를 날리고, Pending 상태를 해제한다.
- 처리된 이벤트는 스트림에서 삭제하도록 하여 Redis 메모리 공간을 절약하도록 한다.
5. 고민 & 개선 포인트
5-1. Producer만 계속 돌아 Stream에 이벤트가 쌓인다면? (메모리 폭발)
현재 Producer는 무작정 XADD를 하고 있다. 만약 Consumer는 다운되고 스케줄러만 계속 돌아 Stream에 이벤트가 계속 쌓인다면 Redis 메모리가 가득 찰 때까지 스트림이 커진다.
대안은 다음과 같다.
- Sharding 전략
여러 개의 Stream으로 쪼갠다. Producer는 해시 값에 따라 분산 저장하고, Consumer Group도 각 Stream을 전담해서 처리한다. 데이터가 매우매우매우 크다면 고려해볼만 하다. - MAXLEN 제한
스트림을 제한한다. 오래된 이벤트는 자동으로 삭제되도록 처리하는 것이다. MAXLEN을 사용하여 제한할 수 있다. 단점은 500만 건의 데이터를 처리해야하는 상황에서 10,000으로 적용하면 499만 개 데이터가 유실되는 문제가 있을 수 있다.
5-2. Consumer 실패 전략은?
현재 Consumer는 catch 블록에서 에러 로그만 찍고 다음 루프로 넘어간다. 여기서 조회한 이벤트는 ACK처리가 안됐으므로 계속 Pending 상태로 남아있는다. 또한 Pending된 이벤트를 재시도 처리하려는 로직은 없다. 때문에 실패 횟수를 카운트하고 일정 횟수 이상 실패하면 별도 키로 옮기거나 XACK 처리하여 이벤트를 버리는 로직이 필요할 것이다.
5-3. 배포나 재시작 시 발생할 우려
Consumer의 onModuleDestroy에서 isRunning을 false로 바꾸고, Redis 연결을 끊는다. 여기서 발생할 수 있는 점은 모든 작업이 즉시 중단되고 데이터가 올바르게 관리되지 않을 수 있다는 점이다. 발생할 우려는 다음과 같다.
- DB에 데이터를 저장하다가 DB 연결이 끊김
- 외부 API를 호출하기만 하고 응답을 받지도 못한 채 크레딧 사용
- 이벤트는 ACK 처리했지만, Stream에서 삭제하지 못해 메모리에 계속 남음
- ACK 처리도 못함
대안은 다음과 같다.
- onModuleDestroy에서 진행 중인 작업을 대기할 수 있도록 Delay 로직을 넣는다.
- Consumer의 처리 상태를 추적하는 변수를 만들어 관리한다.
Reference
- https://redis.io/docs/latest/commands/xgroup-create/
- https://techblog.lycorp.co.jp/ko/building-a-messaging-queuing-system-with-redis-streams
- https://velog.io/@nwactris/MQ-별-특징-3.-Redis-Stream2
- https://kingjakeu.github.io/page2/
- https://redis.io/docs/latest/commands/xreadgroup/
- https://jybaek.tistory.com/935
- https://cano721.tistory.com/248#%EC%86%8C%EB%B9%84%EC%9E%90_%EA%B7%B8%EB%A3%B9%EC%9D%B4%EB%9E%80?
- https://jaehong21.com/ko/posts/uptimeninja-redis-stream/