개요
가끔 스케줄러를 실행하는데, 너무 성능이 느려 인스턴스를 여러 대 늘릴 수도 있다. 예를 들어, 쿠폰 발급이나 알림을 전송하는 속도가 너무 느리다는 것이 그 이유가 될 수 있다. 인스턴스가 1대에서 N대로 늘었기 때문에 처리 속도는 빨라질 수 있지만, 데이터베이스 자원에 접근하는 프로세스도 여러 개가 되기 때문에, 같은 자원을 중복 처리한다던지, 아니면 락 점유 시간이 길어져 데드락이 발생할 수도 있다.
내가 프로젝트로 진행한 와글와글(WaggleWaggle)은 실시간 인구 혼잡도 API를 통해 혼잡도 정보를 가져오고, 데이터를 가공하여 DB에 저장한다. 약 5분 간격으로 혼잡도 정보를 갱신한다.
여기서, 인스턴스 수를 늘렸을 때 MySQL에서 제공하는 Skip Locked로 중복 처리(동시성) 문제와, 데드락 발생을 없애보도록 한다.
1. 반드시 Skip Locked이어야만 할까?
아니다. 다른 방법도 많다.
아래처럼 위의 문제를 해결하는 방법은 여러가지가 있다.
- Message Queue
아키텍처적으로 가장 깔끔하다. Producer가 이벤트를 발행하여 큐에 넣고, Consumer가 큐에서 하나씩 꺼내와서 처리한다. 하지만, 서비스에서 사용중인 인프라가 아니라면 관리해야 할 포인트가 늘어나는 것이 단점이다. - Modulo 연산
락을 아예 사용하지 않고, 각 프로세스가 처리할 구역을 미리 정한다. id를 기준으로 나누는 것이 일반적이지만 서버가 늘어나면 코드를 수정해야하는 유연성이 부족하고, 서버 A가 죽으면 A가 처리할 데이터는 아무도 처리하지 않게 된다.- 서버 A : id % 3 == 0 인 것만 처리
- 서버 B : id % 3 == 1 인 것만 처리
- 서버 C : id % 3 == 2 인 것만 처리
그렇다고 Skip Locked가 무조건 좋은 건 아니라, 모두 전략이기 때문에 상황에 맞게 사용하면 좋을 것 같다.
2. 테이블 정의
와글와글 프로젝트는 인구 혼잡도를 실시간으로 보여줘야하기 때문에, 지역별 인구 혼잡도를 DB에 저장할 수 있도록 한다. 아래와 같이 정의했다.
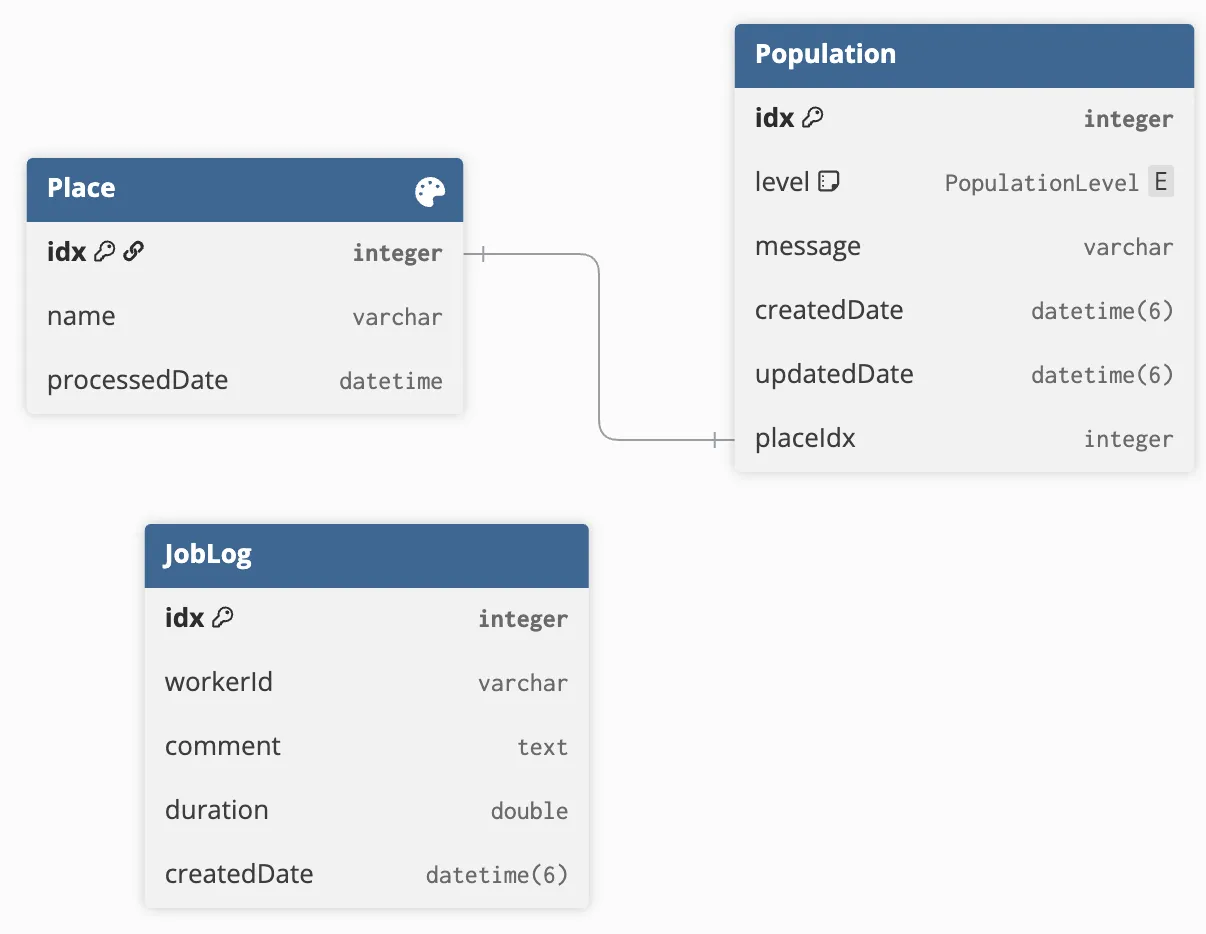
- Place: 데이터를 수집할 주요 장소 테이블
- Population: 인구 혼잡도 데이터를 관리하는 테이블. Place 테이블과 1:1 매핑되어 있다.
- JobLog: 로그를 저장하는 테이블
Place를 기준으로 혼잡도 데이터를 수집하고, Population 테이블에 값을 갱신시킨다. 만약, 존재하지 않는 데이터라면 Insert 한다. (Upsert 사용)
갱신이 완료됐다면, Place의 processedDate를 갱신시켜준다.
3. 테스트 방식 및 기대 효과
우선, 전체 흐름은 다음과 같다. PM2를 사용해서 스케줄러를 Fork 모드로 4개 띄운다.
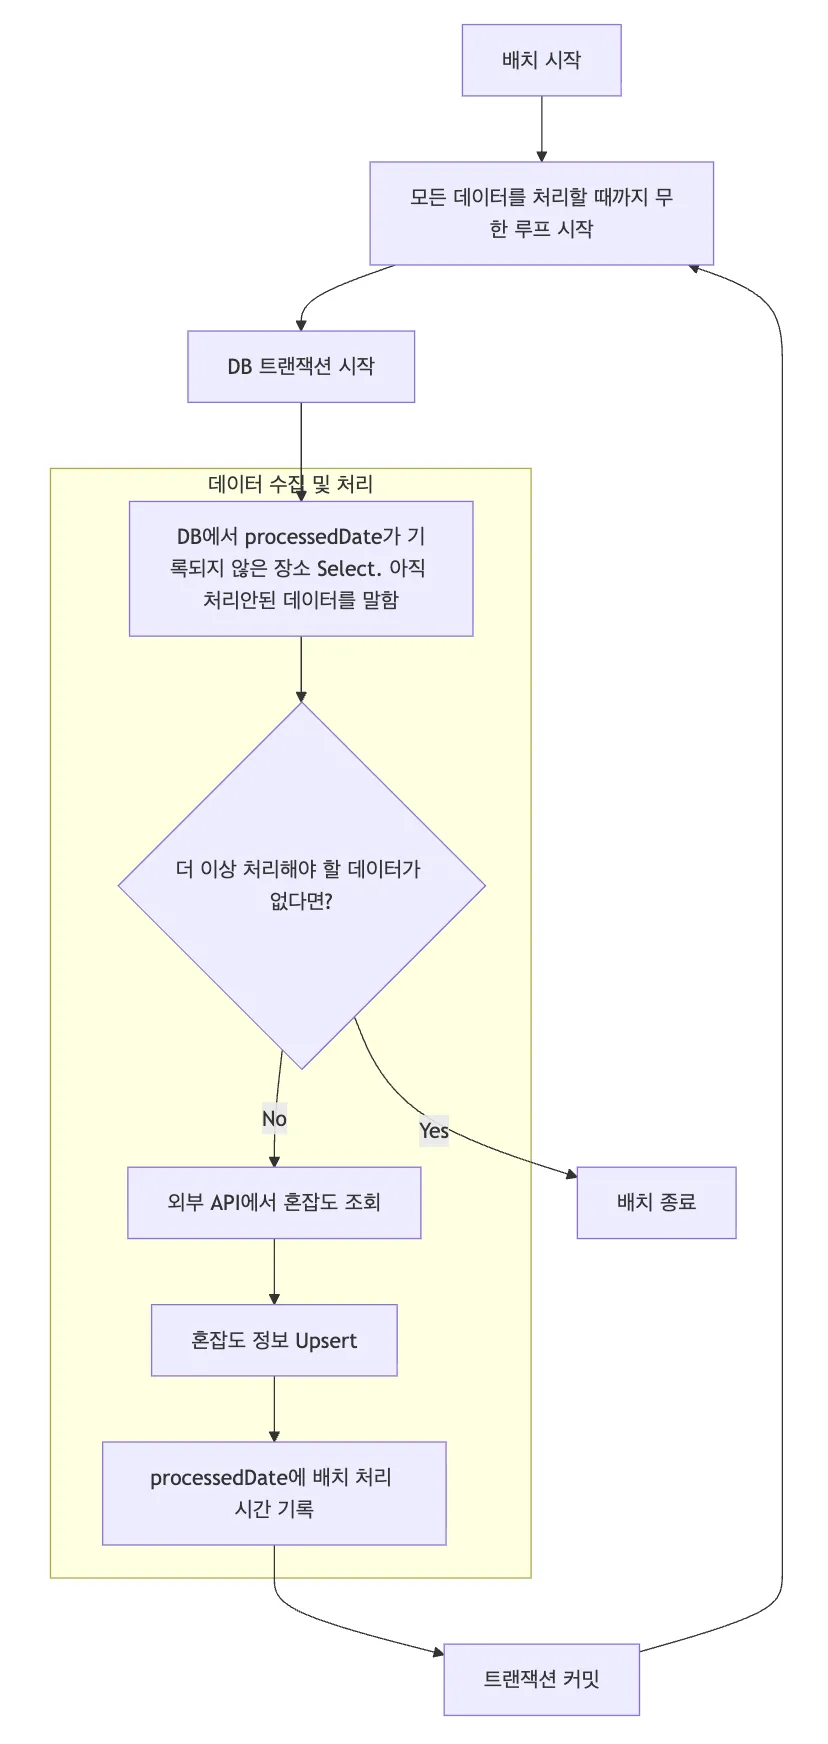
여기서 중요한 부분은 DB에서 처리되지 않는 데이터를 Select할 때, Skip Locked를 적용하냐 안하냐의 차이를 확인한다.
적용하고 안하고의 차이를 확인할 때 다음과 같은 결과를 예상할 수 있다.
- Deadlock이 발생하지 않는다.
같은 자원에 대해 Lock을 차지하려고 시도하지 않기 때문이다. - Job Log에는 각 Worker가 데이터를 하나씩 처리했다는 것을 알 수 있다. (동시성 발생 ❌)
이미 Lock이 걸린 Row를 넘겼기 때문이다. - 처리량이 눈에 띄게 높아진 것을 확인할 수 있다.
참고로 테스트 데이터의 갯수는 120개로 매우 적다.
로직이 거대하지도 않아 Lock 점유 시간이 매우 작을 수 있기 때문에,
확실한 변화를 확인하기 위해서 300ms 지연을 두었다.
4. Skip Locked를 설정하지 않고 실행했을 경우
테스트를 위한 실행코드는 아래와 같다. (실제 로직은 이것과는 다르다.)
async run() {
  while (true) {
    // 매 루프마다 새로운 트랜잭션 시작
    const queryRunner = this.dataSource.createQueryRunner();
    await queryRunner.connect();
    await queryRunner.startTransaction();

    try {
      // 처리할 데이터 1개를 가져옴
      const place = await queryRunner.manager.getRepository(Place)
        .createQueryBuilder('place')
        .where('place.processedDate IS NULL')
        .take(1)
        .getOne();

      // 더 이상 처리할 데이터가 없으면 종료
      if (!place) {
        await queryRunner.commitTransaction();
        break;
      }

      // 비즈니스 로직 수행 (API 호출 등 시간이 걸리는 작업)
      await this.fetchAndSavePopulationData(place, queryRunner.manager);

      // 처리 완료 표시
      place.processedDate = new Date();
      await queryRunner.manager.save(place);

      // 커밋 (이때 락이 해제됨)
      await queryRunner.commitTransaction();

    } catch (e) {
      await queryRunner.rollbackTransaction();
      this.loggerService.error(`Failed to process ${place?.idx}: ${e.message}`);
    } finally {
      await queryRunner.release();
    }
  }
}
place를 조회할 때, 아무런 설정 없이 처리할 데이터 1건을 가져온다.
PM2 Fork 모드로 스케줄러 4대를 띄운다.
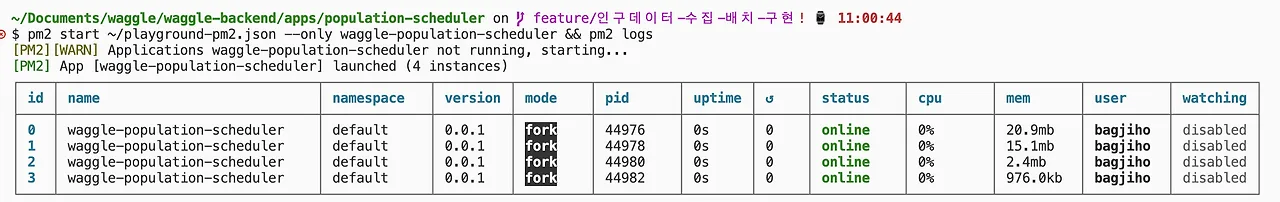
4-1. 결과
4개의 스케줄러가 시작되고, 데이터를 처리하던 도중 다음과 같은 에러가 발생했다.
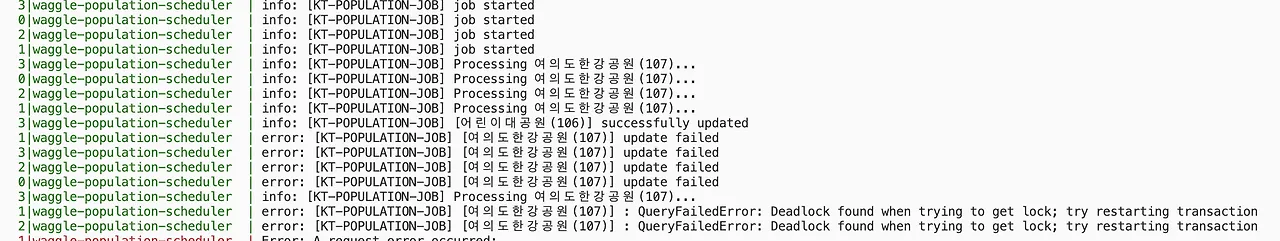

107번 데이터인 ‘여의도한강공원’의 혼잡도 데이터를 처리하다가, Deadlock이 발생한 것이다. 왼쪽의 process id를 보면 0~3번의 스케줄러 모두가 Deadlock 에러가 발생했고, ‘update failed’ 에러가 발생한 것을 알 수 있다.
조금 더 로그를 추적해보면, 0, 3 스케줄러가 해당 데이터를 처리했다고 로그가 남겨져있다. 하지만, 스케줄러 2개가 데이터를 중복 처리했음을 알 수 있다.

아래 Job Log의 결과를 보면 107번 ‘여의도한강공원’ 뿐만 아니라, 데이터를 성공적으로 처리했다는 로그가 2개씩 남겨져있다.
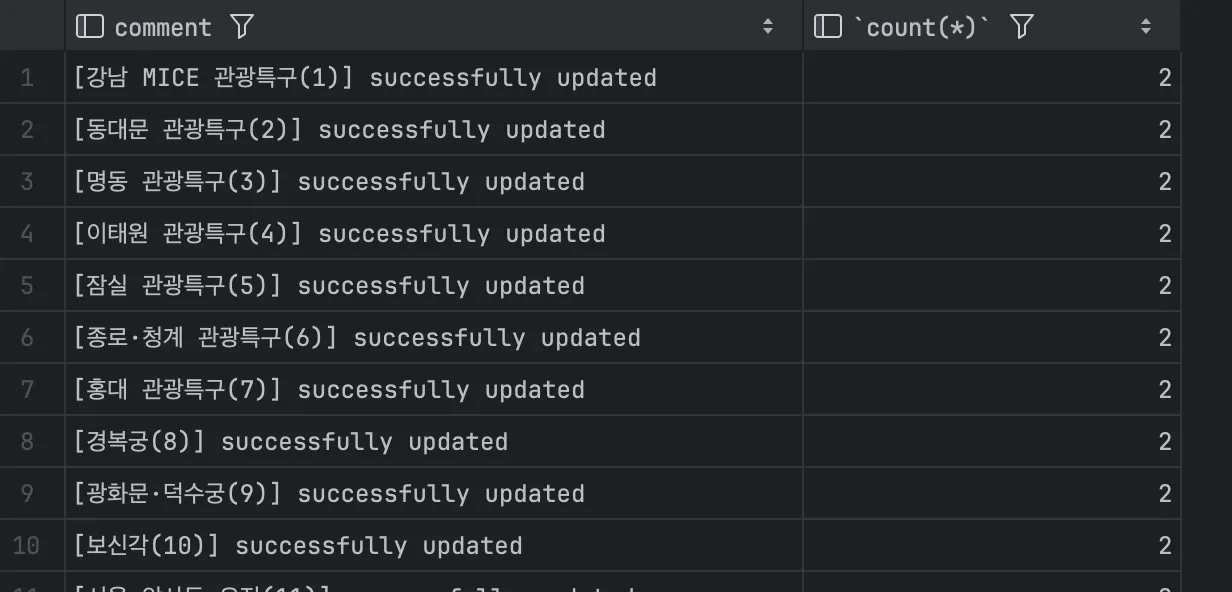
실행 시간을 확인하려고 하니, 스케줄러 1, 2의 로그는 찾을 수 없었고 0, 3 스케줄러만 남겨져있었다. 심지어, 처리 시간이 약 45s가 넘는다.

4-2. 정리
정리하면 다음과 같은 현상이 발생했다.
- 모든 스케줄러에서 Deadlock 에러가 발생했다.
- 데이터를 중복 처리했다. (동시성 문제 발생)
- 실행 시간이 길다. 심지어 실행 로그도 제대로 남지 않은 것을 보아, 스케줄러가 비정상적으로 종료되었음을 알 수 있다.
5. Skip Locked를 설정하고 실행했을 경우
로직은 단순하다. 아래와 같이 Place를 Select하는 부분에서 Skip Locked를 설정하면 된다.
const place = await queryRunner.manager.getRepository(Place)
  .createQueryBuilder('place')
  .setLock('pessimistic_write') // 배타 락(Write Lock) 설정
  .setOnLocked('skip_locked')   // 잠긴 행은 대기하지 않고 건너뜀
  .where('place.processedDate IS NULL')
  .take(1)
  .getOne();
위와 같은 방식으로 똑같이 스케줄러 4대를 띄우고 결과를 확인해본다.
5-1. 결과
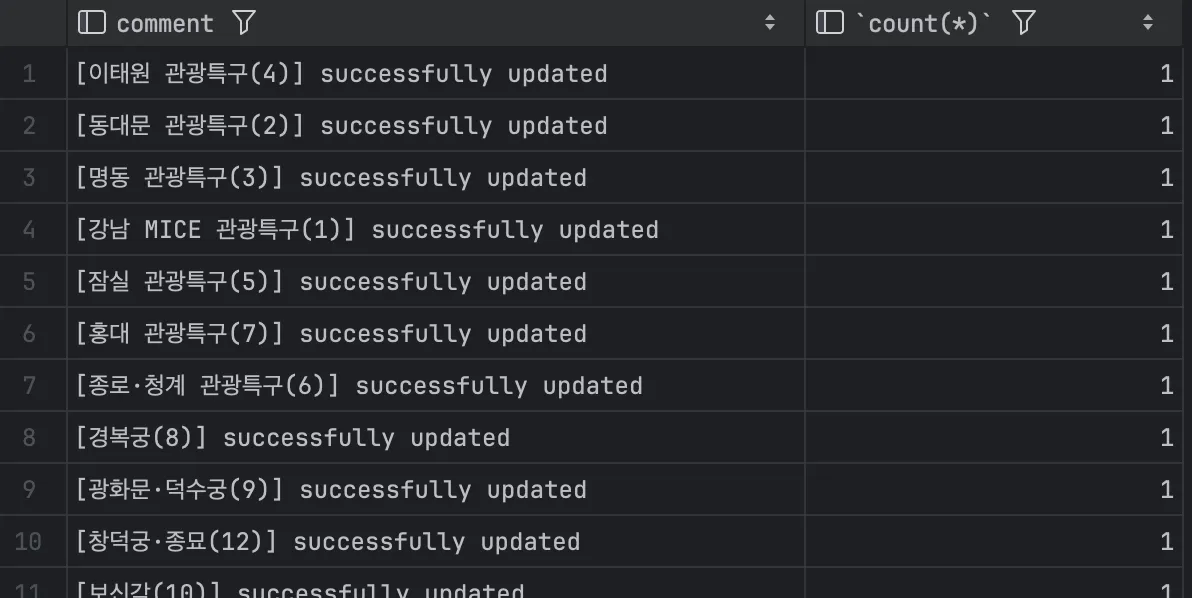
4개의 스케줄러가 실행되고, 로그를 지켜본 결과 실패 에러가 발생하지 않았다. 혹시나해서 Job Log를 확인해보니, 데이터를 성공적으로 처리했다는 로그가 모두 1개씩 찍혀있었다.
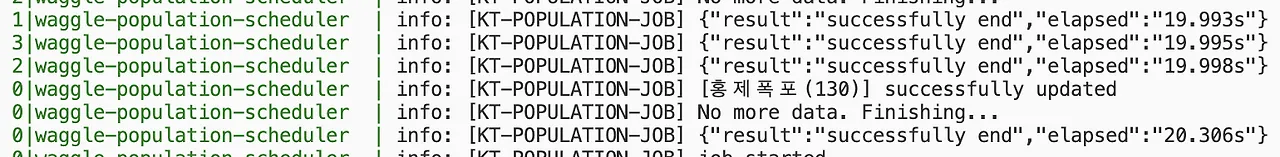
실행 시간도 상당히 단축되었다. 모든 스케줄러가 20s 이내로 단축됨을 알 수 있었다.
5-2. 정리
정리하면 다음과 같다.
- Deadlock 에러가 발생하지 않았다.
- 데이터를 중복 처리하지 않고, 각 스케줄러가 1개의 데이터를 처리했다.
- 실행 시간이 45s에서 20s 이내로 상당히 단축되었다.
6. 결론
| Deadlock 발생 | 중복 처리 | 실행 시간 | |
|---|---|---|---|
| Skip Locked 미적용 | ⭕ | ⭕ | 약 45s (심지어 스케줄러가 비정상적으로 종료되어 모든 로그가 남지 않음) |
| Skip Locked 적용 | ❌ | ❌ | 약 20s |
- 여러 스케줄러가 자원에 접근해서 처리해야하는 상황이라면, Skip Locked가 매우 효과적이다.
- Message Queue와 같이 복잡한 인프라 없이 Queue의 역할을 하게 한다.
6-1. 개인적인 생각
Skip Locked는 기술적으로 봤을 때, 상태 값(Pending -> Processing -> Done)이 있을 때 가장 강력하게 동작하는 것 같다. 예를 들면 쿠폰 발행이라던지, 아니면 좌석 예매 등의 데이터 처리일 것이다. 그 이유는 데이터의 생명주기와 관련있을 것 같다. 지금 위의 예시는 일회성 처리가 아니라 주기적으로 갱신해야하는 성격을 가지고 있다. 일단 예제를 구현하며 느꼈던 것은
- 정확한 값이 없으니 시간 계산을 해야함
- 처리된 시간을 계속 갱신할 때, 어떤 기준으로 갱신해야할지 불편함
- 특히, 시간으로만 확인했을때 처리된 데이터인지 직관적으로 구별이 안됨
주기적으로 갱신해주기 위해 위의 고민을 불필요하게 해야하는 것이다. 외부 스케줄러가 갱신할 대상을 선별하고, 그 대상을 처리하는 프로세스가 있으면 좋을 것 같다는 생각을 했다. Producer/Consumer 구조가 이 문제를 해결하기에 좋은 기술이고, Producer가 Message Queue에 정보를 갱신할 대상을 넣어주고 Consumer가 하나씩 처리하는 구조를 생각했다.
그래서 다음에는 Redis Streams로 MQ 아키텍처를 도입하는 글을 작성하고자 한다.