개요
서비스에서 누가, 언제, 어떤 리소스에 대해 작업을 수행했는지 기록하고 추적하기 위해 감사 로그가 필요했다.
모든 이벤트에 대해 무작정 쌓는 것이 아니라, 어떤 관점으로 로그를 바라보고, 어떻게 쌓고, 어떻게 관리할지 고민이 필요했다.
1. 감사 로그를 바라본 나의 관점
먼저 감사 로그를 어떤 방식으로 사용할 것인지 나의 관점으로 정의하여 정리해보았다.
애플리케이션의 기능으로 실시간으로 조회할 것인가, 아니면 필요할 때 분석 목적으로 조회할 것인가?
➡️ 사용자가 지난 10분동안 무엇을 했는가와 같은 로그를 보고 싶은게 아니라, 필요할 때마다 감사/분석용으로 쓰고 싶다.
로그의 보관 기간은 어떻게 되는지
➡️ 감사 로그는 잠깐 쓰고 버릴 데이터가 아니다. 장기적으로 보관한다.
대량의 데이터를 장기간 보관하더라도 저장, 조회 비용이 값싸면 좋겠다
➡️ 데이터가 계속 증가하더라도 저장 비용과 운영 비용을 합리적인 수준으로 유지할 수 있어야 한다.
이런 관점에서 대량의 데이터를 장기간 저장하고 필요할 때 분석할 수 있는 저장소가 필요함을 느꼈다.
2. 로그를 어디에 보관해야할까?
DB에 쌓는다면?
서비스를 운영하는데 있어서 사용되고 있는 데이터는 모두 DB를 통해 관리되고 있다.
DB에 logs 테이블을 만들어놓고 append-only하게 처리해도 운영하는데에 문제 없다.
또한 인덱스같은 다양한 조회 전략을 세워 대량의 로그를 실시간으로 빠르게 조회할 수 있다.
비즈니스 로직과 같은 트랜잭션으로 로그를 남길 수 있어 유실 방지에도 강하다.
하지만, 계속 쌓이는 로그 특성상 스토리지 비용이 S3보다 비쌀 것이고, 백업이나 복구, 인덱스, VACUUM 같은 운영 부담이 우리(사람)에게 올 수 있다. 거기에, (미미하겠지만) insert 부담을 DB가 가지게 되므로, 특정 시간에 트래픽이 몰리는 경우 문제가 발생할 수 있다.
S3에 쌓는다면?
스토리지 단가는 확실히 DB보다 싸다. 서울 리전 기준 S3 Standard는 $0.025이고, RDS gp3는 $0.131로 약 5.2배다. 또한 Lifecycle 정책을 만들어서, 오래된 로그를 관리할 수 있다. 그리고, Glue 스키마를 정의하면 Athena에서 쿼리가 가능하다는 장점이 있다.
하지만, 로그를 직접 s3에 put하지 않는 이상 실시간 조회가 어렵고, 트랜잭션으로 처리하지 않으면 유실되거나 중복될 수 있다.
그렇다면
1에 작성한 나의 관점을 기준으로 S3에 쌓는 것을 택했다. 비록, 트랜잭션의 정합성이나 실시간 조회가 불가능하다는 단점이 있지만, 이 로그를 애플리케이션 레벨에서 빠르게 조회할 이유도 없고, 값싼 비용으로 관리할 수 있다는 부분을 높게 평가했다.
3. 어떻게 조회할까?
s3는 DB가 아니라 파일 저장소이다. DB처럼 쿼리하지는 못하고, 특정 시점의 로그를 알아보려면 직접 파일을 다운받아서 뒤져봐야한다. 나의 니즈는 우리에게 익숙한 도구를 써서, 특정 시점에 필요한 로그를 쿼리할 수 있는 것이다.
- 가끔 조회할 거니까 서버를 띄워두고 싶지 않다.
- 쓴 만큼만 비용을 지불하고 싶다.
- 가장 익숙한 언어인 SQL로 로그를 쿼리하고 싶다.
- 누가 조회할 수 있는지 권한으로 통제하고 싶다.
- 누가, 언제, 어떤 조건으로 조회했는지 기록이 남았으면 좋겠다.
라는 부분을 충족했으면 한다.
조금 알아보니 duckdb와 aws athena라는 것이 비교 대상이었다.
duckDB 괜찮을까?
s3의 파일을 바로 쿼리할 수 있고 도구 자체는 완전 무료라고 한다. 권한도 결국 실행하는 사람의 자격증명으로 s3 GetObject하기 때문에, IAM이나 버킷 정책으로 권한 설정이 가능하다.
하지만, 조회하고 남는 기록은 어떤 파일을 읽었는지까지다. 물론 s3 관련 이벤트를 켜두면 “누가 어떤 파일을 읽었는지” 남는다. 하지만, 쿼리 조건은 남지 않는다. 또한 파일을 실행하는 곳으로 가져와 처리하기 때문에, 가져간 이후의 복사나 유출을 막을 수 없을 것이다.
5번의 이유로, 조회한 기록 역시 감사 대상이라고 생각했다.
그러면 Athena?
athena는 aws에 내장된 조회 도구로서, 5번의 조건을 만족한다. 조회시 cloudtrail에 기록이 남고, 데이터도 aws 밖으로 나가지 않는다.
다만, 쓰는 만큼, 스캔한 만큼 과금된다는 단점이 있지만, 자주 쓰일 일은 없으므로 감당 가능한 비용이다.
(USD 5.00 per TB of data scanned.)
공식 문서에도 적혀있듯이, 데이터 관리와 파티셔닝 전략에 따라 스캔 비용을 줄여, 과금 비용을 절약할 수 있다.
그래서 athena로 조회하기로 했다.
(역시 완전관리형 서비스가 짱이다)
그리고 또
athena가 s3의 파일을 테이블처럼 읽으려면, 어떤 컬럼이 있고, 무엇이 어느 경로에 있는지 알려줄 스키마가 필요하다.
이 역할을 Glue Data Catalog가 한다.
내가 정의한 스키마는 아래와 같다.
kcp 본인인증을 예시로 든다.
{
  "version": "1",
  "id": "0b8e6c1e-3f2a-4c55-9d0e-7a1b2c3d4e5f",
  "timestamp": "2026-10-08T05:12:34.567Z",
  "action": "kcp:verify",
  "metadata": "{\"affected_fields\":[\"name\",\"phone\"],\"count\":1234}",
  "actor": { "id": 42, "email": "user@example.com", "ip": "203.0.113.10" },
  "trace": {
    "user_agent": "Mozilla/5.0 ...",
    "endpoint": "/api/v1/kcp/verify",
    "method": "POST",
    "request_id": "req-abc123"
  }
}version: 스키마 버전id: 로그의 고유 ID (UUID)timestamp: 이벤트가 발생한 시각 (UTC)actor: 누가 했는가id: 작업자의 user idemail: 작업자 이메일ip: 요청 시점의 IP
action: 무엇을 했는가.<resource>:<extra>:<act>형태이고, 조회할 때 중심이 되는 키다.resource: 대상 테이블 또는 데이터extra: 단건인지 목록인지 같은 부가 구분 (없을 수도 있다)act: 조회, 생성 같은 행위
metadata: 액션마다 다른 부가 정보 (nullable)- 예를 들어 어떤 컬럼이 몇 건 바뀌었는지를
{"affected_fields": [...], "count": 1234}처럼 담는다. - 액션마다 담을 내용이 달라서, 컬럼 구조로 고정하지 않고 JSON 문자열로 넣었다. 나중에 담을 내용이 바뀌어도 스키마를 고치지 않아도 된다.
- 예를 들어 어떤 컬럼이 몇 건 바뀌었는지를
trace: 요청을 추적할 수 있는 정보user_agent,endpoint,methodrequest_id:x-request-id헤더 값. 애플리케이션 로그와 이어 볼 수 있다.
이 구조를 Glue 테이블로 등록해 두면, athena에서 actor.email, action 같은 컬럼으로 쿼리할 수 있다.
4. Athena를 빠르고 싸게 쓰려면 어떤 형태로 쌓아야하나
아무리 가끔 조회한다지만, 쿼리 한 번에 수십 분이 걸리면 답답하고, 비용도 크게 나올 수 있다. 위에서도 언급했듯, athena의 비용은 파일 스캔량과 파티셔닝 전략에 의존된다 생각한다.
그래서 포맷과 경로를 중점으로 고민했다.
JSON + gzip vs Parquet
json은 사람이 바로 읽을 수 있어서 편하다. 하지만, 우리가 조회할 때 쓸 도구는 눈이 아니라 athena다.
또한 athena 입장에서는 원하는 컬럼이 하나뿐이어도 파일 전체를 읽어야 한다. gzip으로 압축하면 용량은 줄지만, 읽어야 하는 범위는 그대로다.
parquet은 데이터를 컬럼 단위로 저장한다. 그래서 쿼리시 WHERE 절로 필요한 것만 필터링할 수 있다. 압축 효율에서도 차이가 나, 오래 쌓일 수록 json과의 스캔량 차이는 벌어질 것이다.
그래서 parquet을 선택한다.
어떤 파일만 읽게 할 수 있을까
s3 key(디렉토리) 구조를 잘 정의해서, athena가 필요한 파일만 스캔하여 조회할 수 있으면 했다. 경로를 잘 나눠두면 athena가 조건에 맞는 경로의 파일만 읽게 할 수 있다.
그래서 아래와 같이 적재되도록 정의했다.
s3://audit-logs/{resource}/{yyyy}/{MM}/{dd}/
파일은 적당히 크게
athena는 파일마다 목록을 조회하고, 열고, 메타데이터를 읽는 고정 비용이 든다. 같은 양의 데이터라도 파일이 잘게 쪼개져 있으면 그만큼 느려진다.
그래서 로그를 한 건씩 바로 파일로 쓰지 않고, 일정량이나 일정 시간만큼 모아서 하나의 파일로 쌓아야 한다. (버퍼 필요)
5. 어떻게 쌓을까?
datadog archiving & forwarding
사내에서 이미 사용하고 있는 조합이다. datadog은 로그를 15일 동안 보관하고, archiving & forwarding 기능으로 s3에 장기 보관도 하고 있다. 보관한 로그를 rehydration하면 datadog에서 다시 확인할 수 있다.
하지만, datadog의 로그는 실시간으로 관측하기 위한 ‘애플리케이션의 로그’들이 쌓이고 있고, (내가 바라본 관점과는 괴리감이 있다) parquet 포맷을 지원하지 않는다.
직접 s3에 putObject
가장 단순하다. 이벤트가 발생하면 putObject를 호출해서 직접 파일을 넣는다.
하지만, parquet으로 변환하고, 로그 한 건이 한 파일로 쓰지 않도록 버퍼 로직을 개발해야한다. 또한 쓰기에 실패시 재시도 로직을 개발해야한다. 인프라 관리 부담은 줄지만, 기능 개발과 유지보수라는 부채가 쌓인다.
SQS
SQS에 넣기만 하면 되니, 버퍼나 재시도 부분은 해결된다. 하지만, parquet으로 변환하는 부분은 직접 개발해야하는 과제로 남는다.
Amazon Data Firehose
Firehose는 데이터를 버퍼에 모아두었다가, 일정 크기가 차거나 시간이 지나면 원하는 저장소로 보내주는 aws 완전관리형 서비스이다. 필요했던 것을 맞춰보면 아래와 같다.
- parquet 변환 가능
- dynamic partitioning으로 원하는 경로 지정 가능
- Buffering 기능 제공: 일정 크기가 차거나 시간이 지나면 적절히 변환해서 목적지로 보냄
- 전송 실패시 재시도할 수 있는 기능 제공
- s3에 전송 실패시 최대 24시간 재시도
- 잘못된 데이터가 들어왔을 경우(parquet 변환, 또는 파티셔닝 실패), s3의 errors/ 경로에 실패한 원본 레코드를 저장
6. 최종 아키텍처
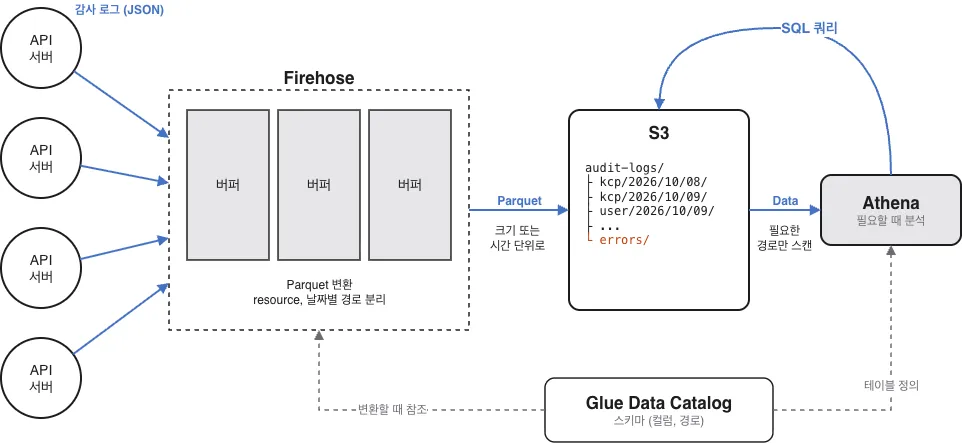
Reference
- https://docs.aws.amazon.com/ko_kr/firehose/latest/dev/what-is-this-service.html
- https://aws.amazon.com/ko/pm/kinesis
- https://aws.amazon.com/ko/firehose/pricing/?refid=eb5e4b75-b4be-4b59-87c1-fca838087b27
- https://aws.amazon.com/ko/s3/pricing/?nc=sn&loc=4&refid=bdbb278d-6d78-4cd9-9c3b-82aca1fe11a5
- https://aws.amazon.com/ko/rds/postgresql/pricing/?pg=pr&loc=3&refid=e9af97be-605e-46df-953e-956611414540